先定义「哪些商家算在名单里」
「帮我整理纽约的餐厅」看起来很清楚,真正执行时却至少有四个未确定的问题:纽约指行政区还是都会区,餐厅是否包含咖啡店和酒吧,连锁门店按品牌还是按地点计算,暂停营业的商家是否保留。
谷歌地图(Google Maps)更像一个按当前查询返回候选结果的搜索系统,不是可以一次导出的工商名录。名单的边界来自你的查询条件,而不是地图上存在多少个标记。
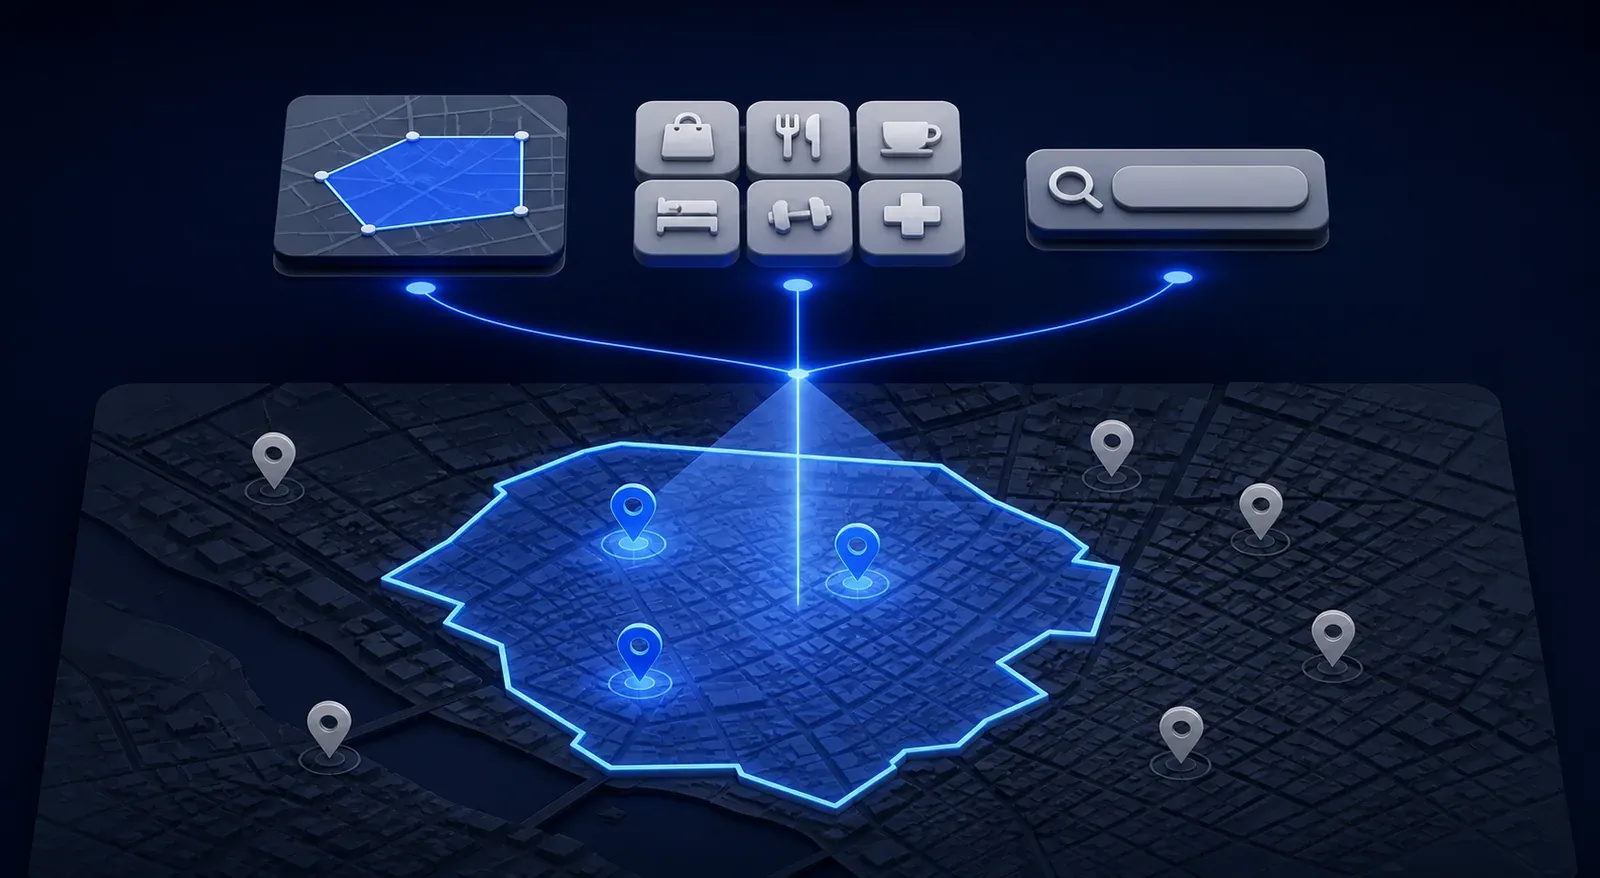
一份可执行的需求至少要固定三组条件:
- 地区范围:国家、城市、邮编、行政区,或明确的经纬度边界
- 商家类别:平台类别、行业同义词,以及需要排除的相邻类别
- 关键词组合:客户会搜索的词、当地语言写法、产品与服务别称
同时还要写清营业状态、评分门槛、最低评论数、是否必须有官网等筛选条件。条件越严格,名单越适合直接使用,但最终条数也会越少。
字段分成四组,别把「能看到」都当成必须要
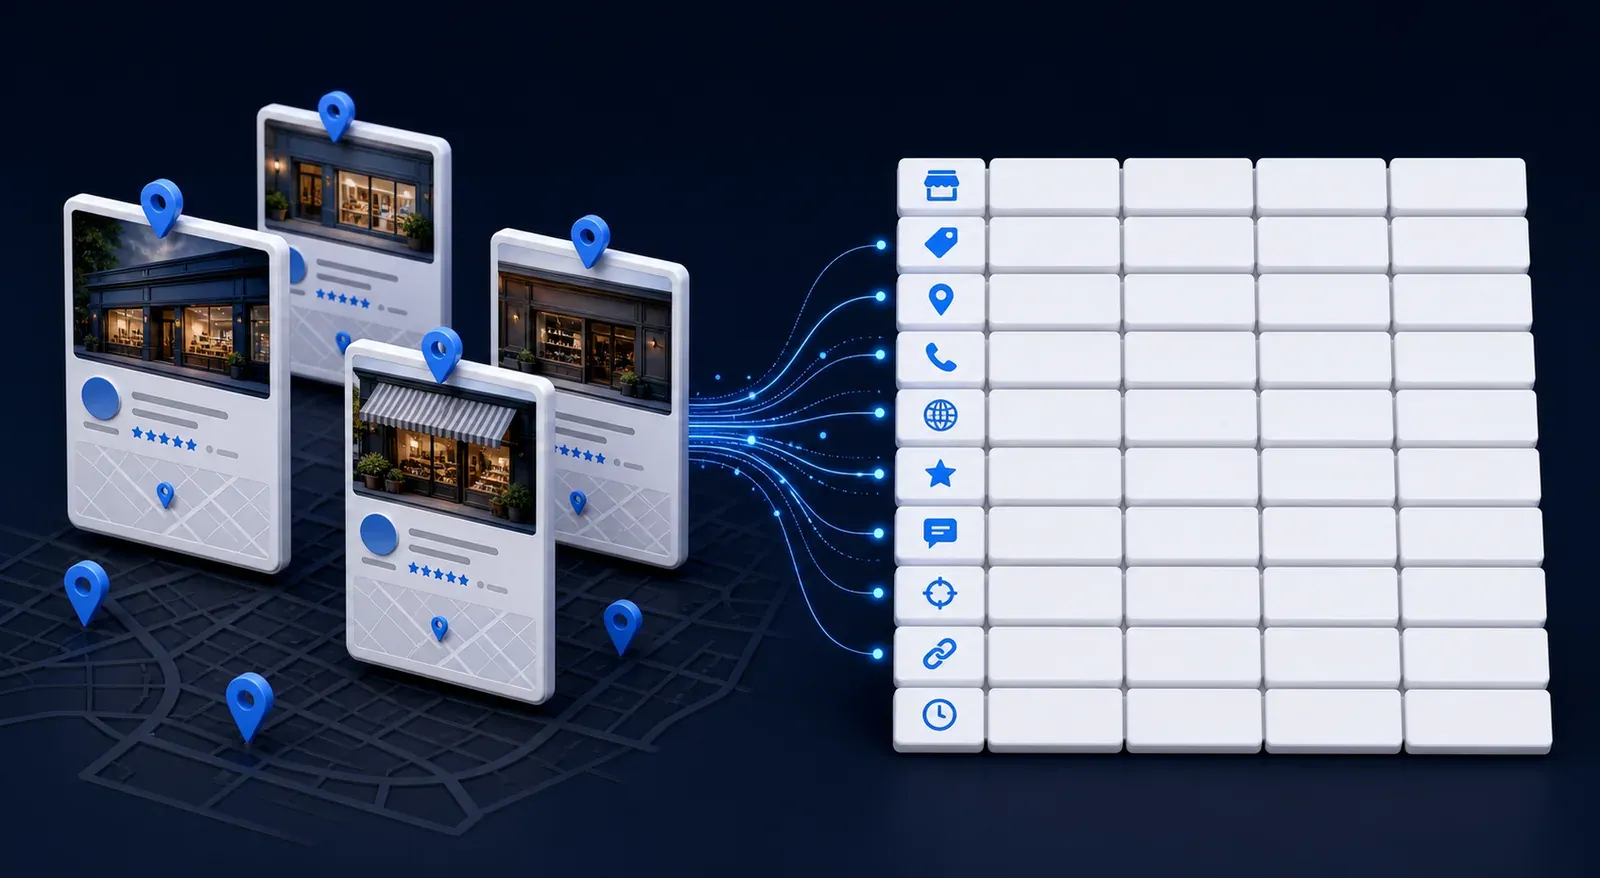
地图商家页可以公开显示很多字段,但不是每个项目都需要全部采集。建议按用途拆成四组:
| 字段组 | 常见字段 | 主要用途 |
|---|---|---|
| 识别字段 | 商家名称、平台标识、类别、来源链接 | 去重、回查、后续更新 |
| 位置字段 | 完整地址、城市、邮编、经纬度 | 区域分析、路线与覆盖判断 |
| 联系字段 | 公开电话、官网 | 企业核实与业务跟进 |
| 口碑字段 | 评分、评论数、营业状态 | 初步筛选与门店表现比较 |
建议额外保留搜索关键词、搜索地区和采集时间。这三个不是商家自己的字段,却决定了结果是怎样被找到的,也决定下次更新能否复现相同口径。
电话、官网和营业时间的缺失很常见。页面没有展示,就不能从地图数据里可靠补出。报价前应该抽样几十到几百条,先测必须有字段的填充率,再决定最终筛选条件。
覆盖度不等于「城市全部商家」
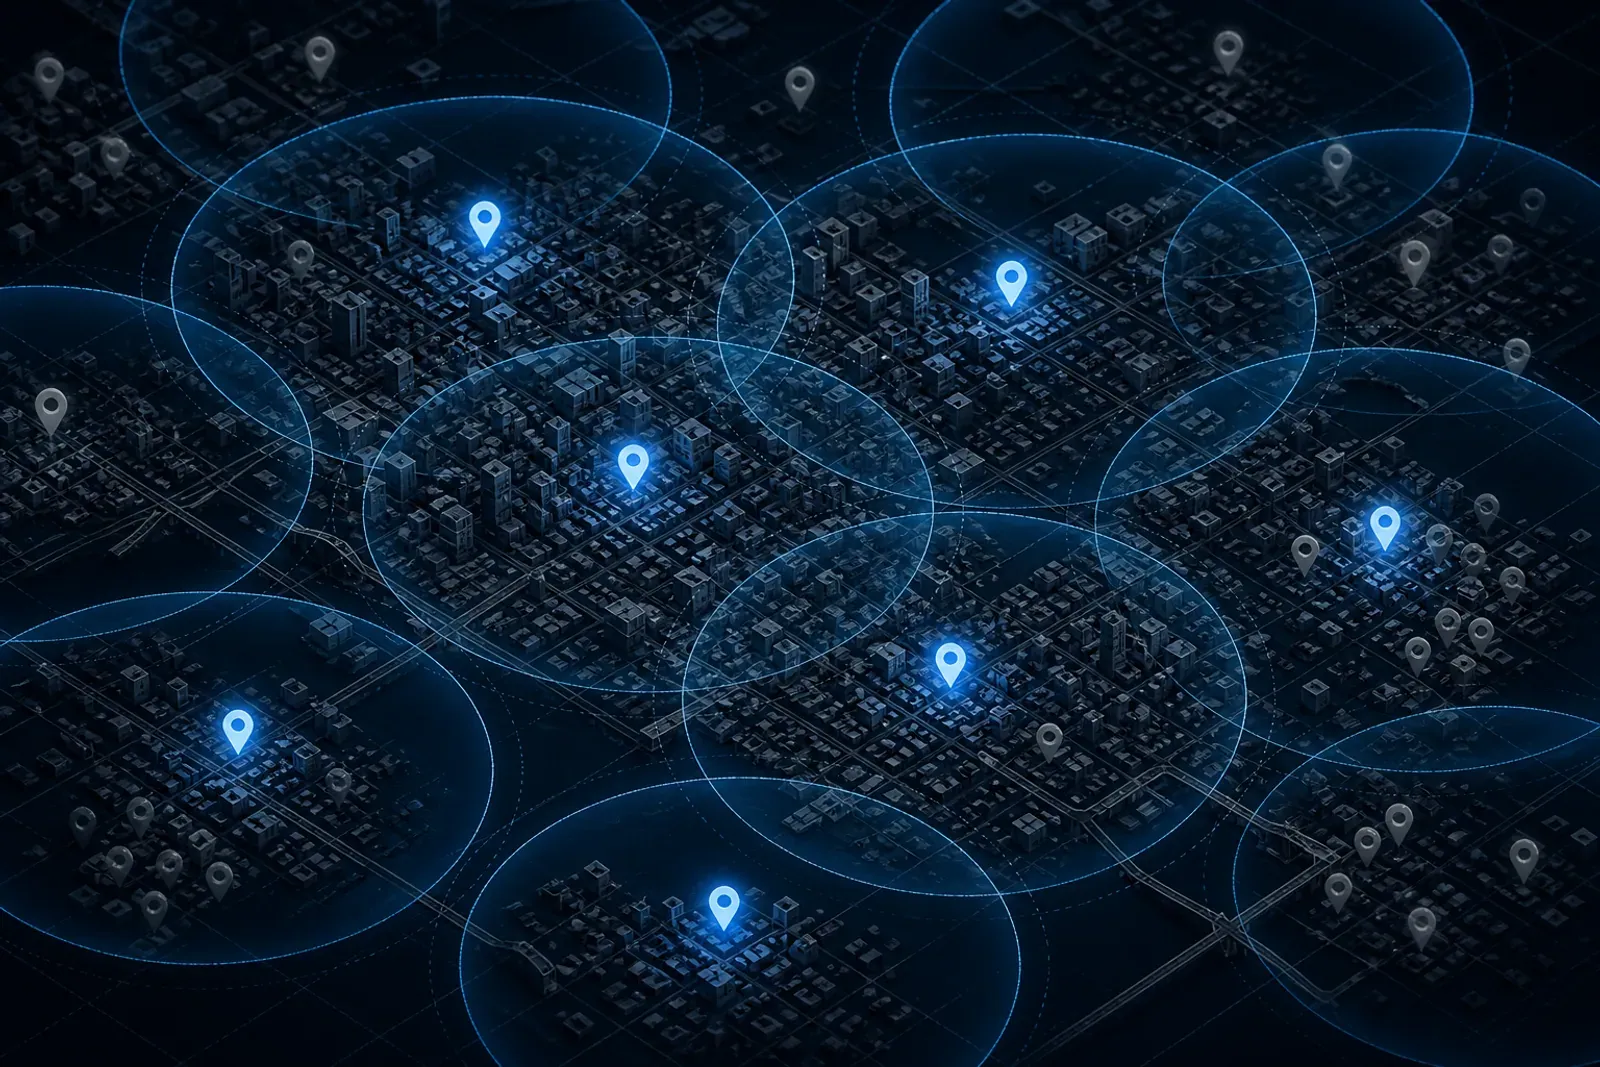
同一个关键词从城市中心搜索,与把城市切成多个小区域分别搜索,得到的结果数量通常不同;换成当地语言或更具体的行业词,也可能发现新的商家。这是地图搜索的产品机制决定的。
提高覆盖度常用三种办法:
- 把大区域切成多个有重叠的小区域,降低单次搜索的范围。
- 把核心类别与当地常用同义词组合,避免只依赖一个中文或英文词。
- 将不同查询结果汇总后去重,并保留每条记录来自哪些查询。
这些方法能提高覆盖度,但仍不能证明结果等于真实商家总数。因此,交付说明应该写「在约定区域、关键词和执行时间内发现的公开商家记录」,不应该写「某城市全部企业」。如果项目需要统计市场总量,还要结合行业目录、协会名录或官方登记数据交叉验证。
去重时,门店和品牌不能混为一谈
一条商家记录可能因为多个关键词、相邻搜索区域或不同类别被重复发现。真正需要删除的是同一地点的重复记录。
去重可以按以下顺序判断:
- 优先使用平台自身的地点标识或稳定来源链接。
- 再比较标准化后的名称、地址、电话与官网域名。
- 对名称相同但地址不同的记录保留为独立门店。
- 对共享电话或官网的连锁门店,不因为联系方式相同就合并。
自动规则无法处理所有情况。例如商场内同一品牌的两个柜台、同址经营的不同品牌、搬迁后保留旧资料的商家,都需要抽样复核。最终交付应同时说明原始条数、去重后条数和使用的去重口径。
动态字段必须带快照时间
评分、评论数、营业状态和营业时间都会变化。没有采集时间的数据,只能说明曾经看到过,却无法判断是哪一天的状态。
如果要做周期监控,第一次采集就应保留稳定标识、来源链接和快照时间。后续更新再增加变化字段,例如评分变化、评论数增量、暂停营业转为正常营业。不要用商家名称作为唯一匹配键,名称可能改写、翻译或加上分店信息。
这也是为什么一次性名单和周期监控的报价不同:后者不只是重复执行,还包括记录匹配、状态比较和异常处理。具体更新规则可以参考周期性数据更新要提前确认什么。
交付验收看五个数字
验收地图商家名单时,条数只是其中一项。更有用的是同时检查:
- 发现记录数:所有查询汇总后的原始记录数量
- 去重后记录数:按约定门店口径保留的唯一记录数量
- 必须有字段填充率:例如官网、电话或完整地址的实际比例
- 来源可回查率:抽样打开来源链接,确认名称、地址和关键字段
- 区域与类别命中率:抽样判断结果是否真的落在目标地区和行业范围
每项都应该给出计算分母。比如「官网填充率 62%」是占原始记录、去重记录,还是筛选后记录的 62%,三者含义完全不同。更完整的验收方法见数据交付应该按什么标准验收。
实例:用 50 条咖啡店样品验收一份名单
本站保存了一份真实的 Google Maps 公开商家 JSON 样品,CSV 与 XLSX 版本可在数据样品页查看。样品查询词为 coffee shop,搜索地区为 Melbourne, Australia,采集时间是 2026-08-24 07:39:13 UTC。以下数字按完整的 50 条文件计算,不是页面上几条预览记录的统计,也不是当前市场数据。
第一步:数记录、检查标识与空值
| 检查项 | 这批样品的结果 | 能说明什么 |
|---|---|---|
| 文件记录数 | 50 条 | 保存的交付文件规模,不是墨尔本商家总量 |
不同 place_id 数 |
50 个 | 文件内按地点 ID 没有重复;无法反推原始搜索结果的去重率 |
| 网站字段非空 | 38 / 50,76% | 12 条没有填写网站字段;非空不等于网站仍可访问或属于独立官网 |
| 名称与地址非空 | 各 50 / 50,100% | 字段完整,不代表名称、地址已经逐条人工核实 |
| 来源链接与采集时间非空 | 各 50 / 50,100% | 有回查与快照依据,不等于来源链接的实时可访问率为 100% |
如果需求规定「必须有网站」,这批文件只会剩下 38 条候选记录,还需要核对链接归属、经营范围与当前营业情况,不能把这 38 条直接称为合格客户。网站字段填充率的分母是全部 50 条;先筛掉空值再计算成 100%,就掩盖了实际缺失。
第二步:核对类别与地区口径
coffee shop 查询返回的主要类别不只有一种:Coffee shop 41 条、Cafe 7 条、Espresso bar 1 条、Coffee roastery 1 条。如果需求只接受主要类别严格等于 Coffee shop,会保留 41 条;如果接受相近经营类型,则需要事先约定后三类是否纳入。这是类别筛选,不是判断其余商家一定无关。
位置字段也不能直接当作城市边界证明。文件的 city 有 28 个不同标签,包括 Lilydale、Ringwood 和 Clayton 等地;不能因为搜索地区填写 Melbourne,就把每条 city 强制改成 Melbourne。若需求限定行政区、邮编或特定半径,还需按地址或另行获取的坐标核对,本文件没有坐标,尚不能计算区域命中率。
同一份文件的 region 有 49 条写作 Victoria、1 条写作 VIC。按澳大利亚地区规则确认映射后,可以增加标准化字段,将两种写法归入同一地区,同时保留原始值供回查。只按字符串分组,会误把它们统计成两个地区。
第三步:把尚未验证的项目写清楚
这批样品的 status 全部记为 open,只表示采集时的记录状态,不保证今天仍在营业。此次统计没有逐条重新打开商家页或网站,所以来源可回查率、网站可访问率和区域命中率仍是待验证项,不能拿字段非空率代替。
公开文件已排除电话、邮箱、联系人和评论正文。因此它可以说明商家名单的验收方法,却不能计算电话填充率、分析差评主题或展示所谓完整销售线索。要增加这些业务范围,应先明确必要字段并做新测试。缺失值不补猜测,未采集字段不写成「平台没有」,历史快照也不冒充最新调研。
适合做什么,不适合做什么
地图商家名单适合有实体地点的行业,例如餐饮、零售、维修、医疗机构、酒店和本地服务商。常见用途包括区域市场扫描、门店覆盖比较、经销商候选整理和企业级公开联系方式核实。
它不适合替代工商登记数据,也不适合寻找没有公开地点的纯线上公司、贸易公司或个人从业者。要找这类企业,通常要结合 B2B 目录与行业名录;如果目标是外贸客户开发,可以先看外贸客户怎么找:公开数据能做到哪一步。
提需求时把这六项一起给出
- 目标国家与地区:最好给行政区、邮编或边界说明
- 行业与关键词:包括当地语言和需要排除的相邻类别
- 门店口径:连锁门店是否分别保留,临时停业是否保留
- 必须有字段:电话、官网、地址等,哪些缺一不可
- 数量与覆盖目标:要固定数量、尽量覆盖,还是满足条件即止
- 交付与更新方式:XLSX、CSV 或 JSON,一次性还是周期更新
收到这些信息后,先做小规模测试,给出实测字段、填充率、重复率和预计可交付数量,再决定是否扩大。平台字段与真实脱敏样例可在 Google Maps 数据采集服务页查看。